
Skills do OpenClaw: como instalar e criar a sua (com código)
Resposta rápida Skill do OpenClaw é uma pasta com um SKILL.md: cabeçalho YAML (name, description) + instruções em Markdown. Instala-se do ClawHub com 'openclaw skills install @owner/slug' (reinicie a sessão depois), cria-se a própria em ~/.openclaw/workspace/skills/ (prioridade máxima), e skill de terceiro deve ser tratada como código não confiável — leia antes, use 'verify' e […]
Como instalar o OpenClaw Gateway: guia direto e seguro
Resposta rápida Para instalar o OpenClaw Gateway: máquina sempre ligada com macOS, Linux ou Windows (WSL2) + Node.js 22.19+, depois 'npm install -g openclaw@latest' e 'openclaw onboard –install-daemon'. Conecte um canal (WhatsApp, Telegram…), pareie o celular com aprovação manual e faça o hardening mínimo: nunca expor a porta 18789 — acesso remoto só via Tailscale/wss://. […]
O que é OpenClaw: o guia do agente de IA self-hosted
Entenda o que é o OpenClaw: agente de IA open-source e self-hosted que executa tarefas reais. Arquitetura, skills, custos e o que você precisa para rodar.
OpenClaw chega ao Android e iOS: seu agente de IA no bolso
OpenClaw lançou apps oficiais para Android e iOS: um companion node que dá câmera, voz, localização e Canvas ao agente de IA self-hosted. Veja como começar.
Cache semântico para LLM: pare de pagar 2× pela mesma resposta
Resposta rápida O cache semântico para LLM usa embeddings para reaproveitar respostas de perguntas com o mesmo significado, cortando 20-70% das chamadas; o limiar de similaridade controla o equilíbrio entre economia e falso positivo. Cache exato falha em linguagem natural; o semântico acerta por significado. O fluxo é: embed, buscar vizinho, comparar com o limiar, […]
Como cortar o custo de tokens de LLM em produção sem perder qualidade
Resposta rápida Para reduzir o custo de tokens de LLM em produção, meça o consumo por feature, enxugue o contexto, limite a saída, cacheie por significado e roteie cada tarefa ao modelo mais barato que resolve. Saída custa 3 a 5 vezes mais que entrada — defina max_tokens sempre. 20% das features consomem 80% do […]
10 Skills de IA Que Valem Mais Que Diploma em 2026 — Com Prova
72% das contratações em IA no Brasil foram de profissionais sem diploma específico. O mercado quer portfolio, não certificado. 10 skills demonstráveis em 30-90 dias que pagam R$12K+.
Claude Partner Network: US$100M Em Créditos Para Quem Constrói Com IA — E o Brasil Está Dormindo
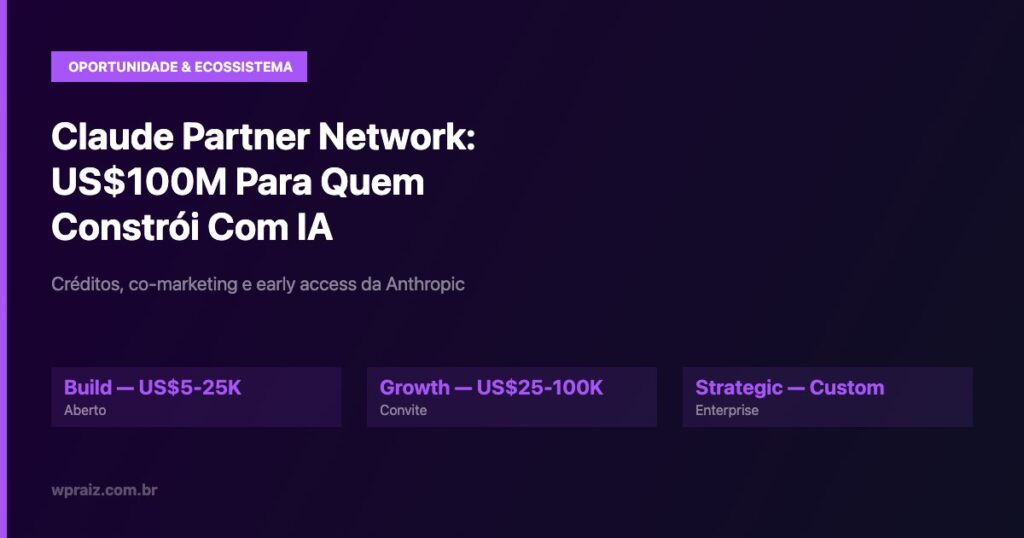
A Anthropic lançou o Claude Partner Network com US$100M em créditos, co-marketing e early access. 3 tiers de parceria. 4 oportunidades enormes no mercado brasileiro. E a competição está dormindo.
O Fuso Horário Brasileiro É Sua Maior Vantagem Com IA — E Quase Ninguém Percebeu
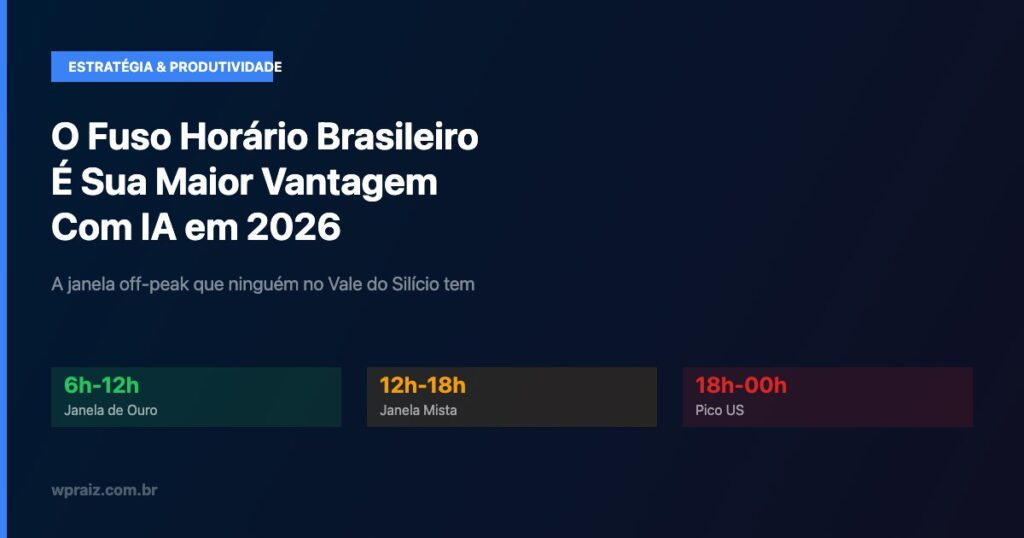
Devs brasileiros têm uma janela de ouro entre 6h-12h BRT onde Claude e GPT operam com 3-5x mais capacidade. Fuso horário off-peak + custo de vida baixo = arbitragem geográfica de talento em IA.
5 Profissões Que a IA Criou em 2026 — E Que Já Pagam R$15K+ no Brasil
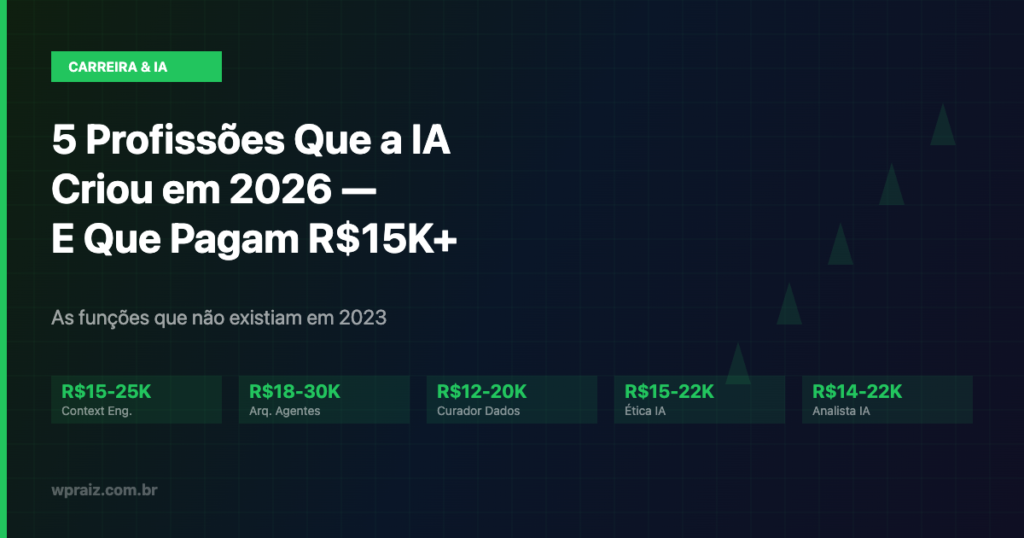
Context engineer, arquiteto de agentes, curador de dados, ética de IA, analista de negócios IA. 5 funções que não existiam em 2023 e hoje pagam R$15K-30K no Brasil. Como entrar em cada uma.